Kategorie: Experience

Reports out of real life

  • Stellungnahme zur Nationalen CVD-Policy (Leitfaden, Fassung 2026)

    Gegenstand„Nationale CVD-Policy – Leitfaden“, Bundesministerium für Inneres, Wien 2026 (Datei vom 18. Juni 2026)
    Inhaltlich verantwortlich laut LeitfadenBMI, BKA, BMJ (Straf- und Zivilrecht), Datenschutzbehörde, CERT.at
    VerfasserChristoph Gruber, CTO und CISO
    Version1.0
    Stand22. Oktober 2026
    KlassifizierungÖFFENTLICH

    Zusammenfassung

    Die Fassung 2026 der Nationalen CVD-Policy ist ein solider Prozessleitfaden. Sie beschreibt den Ablauf einer koordinierten Offenlegung von der Verifikation bis zur Veröffentlichung in der European Vulnerability Database nachvollziehbar, nennt CERT.at als Koordinator nach § 11 NISG 2026 und verweist auf internationale Standards wie security.txt, CVE und CSAF. Neu und wertvoll ist das Kapitel zu Art. 10 EMRK.

    Den eigentlichen Auftrag des Nationalrats erfüllt der Leitfaden jedoch nur zur Hälfte. Die Entschließung vom 21. Jänner 2026 verlangte neben einem Leitfaden ausdrücklich die Evaluierung und gegebenenfalls Anpassung der straf- und datenschutzrechtlichen Bestimmungen, damit ethisch handelnde Sicherheitsforschende Rechtssicherheit haben. Eine solche Anpassung ist nicht erfolgt. Der Leitfaden stellt selbst klar, dass sich aus ihm keine Befreiung von rechtlichen Folgen ergibt.

    Daneben weist der Leitfaden inhaltliche und redaktionelle Mängel auf. Die wichtigsten sind die fehlende Absicherung der Anonymität gegenüber Strafverfolgungsbehörden, eine Asymmetrie der Fristen zulasten der Meldenden, eine ungeregelte Ausnahme für die „nationale Sicherheit“, ein dogmatisch fehlerhaftes Datenschutzkapitel und eine veraltete Darstellung des Cyber Resilience Act.

    Am schwersten wiegt ein Punkt, den der Leitfaden gar nicht anspricht. Seit Inkrafttreten der NISV 2026 Anfang Oktober 2026 gilt der Anhang der Durchführungsverordnung (EU) 2024/2690 für alle wesentlichen und wichtigen Einrichtungen in Österreich. Nummer 6.10.2 lit. e dieses Anhangs verlangt ein Verfahren für die Offenlegung von Schwachstellen „im Einklang mit den geltenden nationalen Konzepten“. Damit ist ein CVD-Verfahren für rund 5.000 Einrichtungen bereits Pflicht, und der Leitfaden ist faktisch der Prüfmaßstab dafür. Er enthält aber weder einen Hinweis auf diese Pflicht noch Mindestinhalte, an denen sich Einrichtungen und Prüfstellen orientieren könnten.

    Der Vergleich mit Estland, Belgien und den Niederlanden zeigt zwei Wege, die Österreich kombinieren sollte: den belgischen Weg einer gesetzlich geregelten Straffreiheit unter strengen Bedingungen und den estnischen Weg eines Staates, der selbst ein Bug-Bounty-Programm betreibt und seine eigenen Systeme laufend von außen testen lässt.

    Unsere Kernforderungen sind:

    1. eine gesetzliche Safe-Harbour-Regelung nach belgischem Vorbild,
    2. ein gesetzlicher Vertraulichkeitsschutz für die CVD-Kommunikation des Koordinators,
    3. ein transparenter, gesetzlich geregelter Abwägungsprozess für das Zurückhalten von Schwachstellen durch staatliche Stellen,
    4. verbindliche Mindestinhalte für das CVD-Verfahren nach NISV 2026,
    5. eine Überarbeitung des Datenschutz- und CRA-Kapitels.

    Ausgangslage

    Österreich hat 2024 erstmals eine Nationale CVD-Policy veröffentlicht. Im Dezember 2025 wurde im Nationalrat ein Entschließungsantrag mit dem Titel „Ethical Hacking straffrei stellen“ eingebracht. Am 21. Jänner 2026 fasste der Nationalrat mit breiter Mehrheit die Entschließung 67/E XXVIII. GP. Darin wird die Bundesregierung, insbesondere die Justizministerin und der Innenminister, zu zwei Maßnahmen aufgefordert:

    1. einen praxisorientierten CVD-Leitfaden mit klaren Kriterien zu erarbeiten,
    2. die straf- und datenschutzrechtlichen Bestimmungen zu evaluieren und gegebenenfalls anzupassen, sodass für ethisch handelnde Sicherheitsforschende Rechtssicherheit besteht.

    Die vorliegende Fassung 2026 ist die Antwort auf den ersten Punkt. Sie erschien im Juni 2026, also vor dem materiellen Anwendungsbeginn des NISG 2026 am 1. Oktober 2026.

    Der Rechtsrahmen hat sich seither weiter verdichtet:

    • NISG 2026 (BGBl. I Nr. 94/2025): § 11 benennt das nationale CSIRT als CVD-Koordinator und sieht die Möglichkeit anonymer Meldungen vor. § 32 Abs. 4 lit. e verpflichtet wesentliche und wichtige Einrichtungen zu Sicherheitsmaßnahmen „einschließlich Management und Offenlegung von Schwachstellen“. § 32 Abs. 5 ermächtigt die Cybersicherheitsbehörde, nähere Anforderungen per Verordnung festzulegen und Durchführungsrechtsakte der Kommission auf weitere Sektoren zu erstrecken.
    • NISV 2026 (BGBl. II Nr. 290/2026): Die Verordnung wurde am 1. Oktober 2026 kundgemacht und trat mit Ablauf dieses Tages in Kraft. Ihr § 2 erklärt den Anhang der Durchführungsverordnung (EU) 2024/2690 auf alle in den Anlagen 1 und 2 NISG 2026 gelisteten Einrichtungen für anwendbar.
    • Cyber Resilience Act (Verordnung (EU) 2024/2847): Seit 11. September 2026 müssen Hersteller aktiv ausgenutzte Schwachstellen und schwerwiegende Sicherheitsvorfälle über die einheitliche Meldeplattform der ENISA melden. Ab 11. Dezember 2027 gelten die übrigen Pflichten, darunter das verpflichtende CVD-Konzept nach Anhang I Teil II.
    • Messenger-Überwachung: Nationalrat und Bundesrat haben 2025 die Überwachung verschlüsselter Messenger-Dienste beschlossen. Dafür muss der Staat Software beschaffen, die Sicherheitslücken in Endgeräten ausnutzt.

    Positive Aspekte

    Der Leitfaden beschreibt den CVD-Prozess in acht nachvollziehbaren Schritten (Schritt 0 bis 7), von der Verifikation über die Meldung, Bewertung und Behebung bis zur Veröffentlichung in der EUVD. Die Rollen von Schwachstellensuchenden, Anbietern und Koordinator sind klar beschrieben, die farbliche Trennung der Hinweise für beide Seiten erleichtert die Lektüre.

    Fachlich zutreffend sind die Unterscheidung zwischen Onlinediensten und generischer Software, die Empfehlung von security.txt nach RFC 9116, CVSS, CVE und CSAF sowie die Möglichkeit, den Koordinator anonym einzuschalten. Die Grundprinzipien (verantwortliches Handeln, Subsidiarität, Verhältnismäßigkeit, Datensparsamkeit, abgestimmte Fristen und respektvolle Kommunikation) entsprechen internationaler Praxis. Die ausdrückliche Grenze, dass Brute-Force, Denial of Service, Social Engineering, Veränderungen an Systemen und Schadsoftware nur mit schriftlicher „Permission to Attack“ zulässig sind, schafft Klarheit.

    Die strafrechtliche Analyse des § 118a StGB entlang der vier Tatbestandselemente ist für Laien verständlich. Sie steht im Einklang mit dem Erlass des Bundesministeriums für Justiz vom 23. August 2023 zum ethischen Hacking. Das neue Kapitel zu Art. 10 EMRK liefert ein Prüfraster, das in Straf- und Zivilverfahren für eine grundrechtskonforme Auslegung herangezogen werden kann: Falsifizierbarkeit, öffentliches Interesse und Sorgfalt bei der Informationsgewinnung.

    Ehrlich und praxisnah ist schließlich der Hinweis, dass finanzielle Anreize in Verbindung mit automatisierten Scannern und KI-Werkzeugen zu einer Flut minderwertiger Meldungen führen können. Ebenso klar ist die Feststellung, dass Forderungen unter Androhung einer Veröffentlichung als Erpressungsversuch gewertet werden können.

    Kritikpunkte im Einzelnen

    Keine Rechtssicherheit für Sicherheitsforschende

    Die Entschließung des Nationalrats verlangte Rechtssicherheit. Der Leitfaden kann diese als unverbindliche Handreichung nicht herstellen und behauptet das auch nicht. Er verweist auf die Prüfung des Einzelfalls und empfiehlt bei Unklarheit rechtliche Beratung. Damit bleibt die Situation für Sicherheitsforschende im Kern unverändert.

    Der Schutz hängt am erweiterten Vorsatz des § 118a Abs. 1 StGB, also an der Spionage- oder Verwendungsabsicht. Ob diese fehlt, wird aber erst im Ermittlungsverfahren geklärt. Für Betroffene ist schon dieses Verfahren mit Hausdurchsuchung, Sicherstellung von Geräten und Beschuldigtenstatus die eigentliche Sanktion. Der Fall epicenter.works zeigt das: Trotz eingehaltener Responsible Disclosure wurde gegen die Finder nach § 118a StGB ermittelt. Weder ein Leitfaden noch ein Erlass binden Gerichte, und ein Erlass ändert nichts daran, dass eine Anzeige zunächst Ermittlungen auslöst.

    Der Leitfaden behandelt zudem ausschließlich § 118a StGB. Andere Tatbestände, die bei der Schwachstellensuche berührt sein können, bleiben unerwähnt: § 119 und § 119a StGB (Telekommunikationsgeheimnis, missbräuchliches Abfangen von Daten), § 126a und § 126b StGB (Datenbeschädigung, Störung der Funktionsfähigkeit eines Computersystems), § 126c StGB (Missbrauch von Computerprogrammen oder Zugangsdaten) sowie § 63 DSG (Datenverarbeitung in Gewinn- oder Schädigungsabsicht).

    Ein wirksames Instrument, das bereits nach geltendem Recht zur Verfügung steht, erwähnt der Leitfaden nicht. § 118a StGB ist nach Abs. 3 ein Ermächtigungsdelikt: Der Täter ist nur mit Ermächtigung des Verletzten zu verfolgen. Anbieter können daher in ihrer eigenen CVD-Policy verbindlich zusagen, bei richtlinienkonformem Verhalten keine Ermächtigung zu erteilen. Zusammen mit einer ausdrücklichen Zustimmung zur Untersuchung, die die Verfügungsbefugnis begründet und damit den Tatbestand ausschließt, ist das derzeit der stärkste Schutz, den Sicherheitsforschende in Österreich erhalten können. Der Leitfaden sollte Anbietern diese Kombination ausdrücklich empfehlen und eine Musterformulierung bereitstellen.

    Für eine echte Lösung braucht es eine gesetzliche Regelung. Belgien hat mit Art. 22 und 23 seines NIS2-Gesetzes gezeigt, wie eine solche Regelung aussehen kann (siehe Abschnitt 5.2).

    Anonymität und Vertraulichkeit sind nicht abgesichert

    Der Leitfaden stellt in Schritt 1 zutreffend klar, dass der Koordinator nach geltender Rechtslage gerichtlich verpflichtet werden kann, die Kommunikation rund um eine Schwachstellenmeldung offenzulegen. Im Kapitel zum HSchG weist er darauf hin, dass ab einem strafrechtlichen Anfangsverdacht die StPO gilt und in alle Richtungen ermittelt wird, unter Umständen auch gegen die meldende Person.

    Diese Ehrlichkeit ist zu begrüßen. Sie zeigt aber ein strukturelles Problem: Art. 12 Abs. 1 NIS-2-Richtlinie und § 11 Abs. 2 NISG 2026 sehen vor, dass Schwachstellen auf Wunsch anonym gemeldet werden können. Eine Anonymität, die durch eine gerichtliche Anordnung aufgehoben werden kann, ist für Meldende nur eingeschränkt verlässlich. Wer seine Identität dem Koordinator offenlegt, um Rückfragen zu ermöglichen, trägt das Risiko, dass genau diese Kommunikation später gegen ihn verwendet wird.

    Wir empfehlen eine gesetzliche Regelung, die CVD-Kommunikation beim Koordinator einem Beschlagnahme- und Verwertungsverbot unterstellt, vergleichbar dem Schutz journalistischer Quellen. Ausnahmen sollten auf schwere Straftaten mit konkretem Schädigungsvorsatz beschränkt sein. Der Leitfaden selbst betont im EMRK-Kapitel, dass der Quellenschutz eine besondere Rolle spielt und den Staat teilweise eine Schutzpflicht trifft. Diese Überlegung sollte konsequent auf den Koordinator übertragen werden.

    Asymmetrische Fristen

    Der Leitfaden sieht eine Rückmeldung an Meldende binnen 14 Tagen und eine Behebungsfrist von 60 Tagen vor. Danach „kann“ der Koordinator die Schwachstelle offenlegen, wenn dies dem öffentlichen Interesse dient. Fristüberschreitungen sollen abgesprochen werden und können zu Verlängerungen führen.

    Diese Regelung ist in zweifacher Hinsicht unausgewogen:

    • Kein Offenlegungsrecht für Meldende. Anbieter erhalten eine Frist mit Verlängerungsmöglichkeit, Meldende hingegen nie ein eigenes Offenlegungsrecht. Stattdessen warnt der Leitfaden mehrfach vor unkoordinierten Veröffentlichungen und vor Haftungsrisiken. Reagiert ein Anbieter nicht, bleibt den Meldenden nur der Koordinator, dessen Entscheidung im Ermessen liegt.
    • Keine Differenzierung nach Art des Systems. Für Webanwendungen sind 60 Tage angemessen, für Firmware, Hardware, Medizinprodukte und Systeme der Betriebstechnik (OT) oft unrealistisch. International hat sich eine Standardfrist von 90 Tagen etabliert, mit längeren Fristen und Zwischenmaßnahmen für Hardware und OT.

    Wir empfehlen eine Standardfrist von 90 Tagen ab Eingang beim Anbieter, eine begründete Verlängerung auf bis zu 180 Tage für Hardware und OT mit Pflicht zur Veröffentlichung von Zwischenmaßnahmen sowie ein ausdrückliches Recht der Meldenden, nach Fristablauf und Vorankündigung koordiniert zu veröffentlichen. Bei aktiv ausgenutzten Schwachstellen sollten deutlich kürzere Fristen gelten.

    Ungeregelte Ausnahme „nationale Sicherheit“

    In Schritt 6 empfiehlt der Leitfaden, von einer Offenlegung abzusehen, wenn ein öffentliches Interesse überwiegt, etwa die nationale Sicherheit. Kriterien, Zuständigkeiten, Fristen und Kontrolle für eine solche Entscheidung fehlen.

    Das ist problematisch, weil der Staat mit der beschlossenen Messenger-Überwachung ein eigenes Interesse an offenen Schwachstellen hat. Das Bundesministerium für Inneres ist zugleich Herausgeber dieses Leitfadens, oberste Behörde der Cybersicherheitsbehörde und Bedarfsträger für Überwachungssoftware. Ohne transparente Regeln entsteht zumindest der Anschein eines Interessenkonflikts. Das untergräbt das Vertrauen, auf das ein CVD-System angewiesen ist.

    Wir empfehlen einen gesetzlich geregelten Abwägungsprozess für das Zurückhalten von Schwachstellen (Vulnerabilities Equities Process) mit:

    • einer Vermutung zugunsten der Offenlegung,
    • einer zeitlichen Befristung jeder Zurückhaltung mit Pflicht zur Neubewertung,
    • einer unabhängigen Kontrolle,
    • einer jährlichen Berichterstattung an den Nationalrat.

    Ebenso klar sollte geregelt sein, dass Informationen, die CERT.at in seiner Rolle als CVD-Koordinator erhält, nicht für offensive Zwecke an Sicherheits- oder Nachrichtendienste weitergegeben werden.

    Fehler im Datenschutzkapitel

    Das Datenschutzkapitel enthält mehrere Aussagen, die rechtlich nicht tragen oder in die Irre führen.

    Rolle der Suchenden. Der Leitfaden hält Konstellationen für denkbar, in denen Schwachstellensuchende als Auftragsverarbeiter auftreten. Auftragsverarbeitung setzt nach Art. 28 Abs. 3 DSGVO einen Vertrag oder ein anderes bindendes Rechtsinstrument mit Weisungen der Verantwortlichen voraus. Auf beauftragte Penetrationstests kann das zutreffen, auf unbeauftragte Sicherheitsforschende, die der Leitfaden primär anspricht, in aller Regel nicht. Wer ohne Auftrag zufällig personenbezogene Daten zur Kenntnis nimmt, entscheidet selbst über diesen Vorgang. Die Frage nach der Rechtsgrundlage stellt sich dann für ihn selbst.

    Einwilligung als Rechtsgrundlage. Die Bezeichnung der Einwilligung als „für Schwachstellensuchende zentral“ geht an der Praxis vorbei. Betroffene Personen, deren Daten bei einer Schwachstellensuche sichtbar werden, können vorab nicht einwilligen. Tragfähig ist das berechtigte Interesse nach Art. 6 Abs. 1 lit. f DSGVO. Erwägungsgrund 49 DSGVO nennt die Gewährleistung der Netz- und Informationssicherheit ausdrücklich als berechtigtes Interesse, und die Grundsätze der Datenminimierung und Speicherbegrenzung sind dabei strikt einzuhalten. Für Anbieter, die Meldungen verarbeiten, kommen zusätzlich Art. 6 Abs. 1 lit. c DSGVO (Pflichten nach NISG 2026 und CRA) in Betracht.

    Verweis auf §§ 36 ff DSG. Der Leitfaden verweist für die Rechtmäßigkeit der Verarbeitung auf „Art 6 DSGVO beziehungsweise §§ 36 ff DSG“. Das 3. Hauptstück des DSG ab § 36 regelt jedoch die Verarbeitung durch zuständige Behörden zu Zwecken der Sicherheitspolizei und Strafverfolgung. Für private Sicherheitsforschende und Anbieter ist es nicht einschlägig.

    Juristische Personen. Der Satz, für einen Schutz nach der DSGVO komme es „insbesondere auf die Bezeichnung der juristischen Person an“, ist missverständlich. Die DSGVO schützt nach Erwägungsgrund 14 ausschließlich natürliche Personen. Daten einer juristischen Person fallen nur dann darunter, wenn sie sich zugleich auf eine natürliche Person beziehen, etwa bei einer Firma, die den Namen des Inhabers trägt. Den Schutz juristischer Personen gewährt in Österreich § 1 DSG.

    Fehlende Hinweise für Anbieter. Erlangt eine unbeauftragte Person Zugriff auf personenbezogene Daten, liegt in der Regel eine Verletzung des Schutzes personenbezogener Daten vor. Anbieter müssen dann prüfen, ob eine Meldung an die Datenschutzbehörde nach Art. 33 DSGVO binnen 72 Stunden und gegebenenfalls eine Benachrichtigung der Betroffenen nach Art. 34 DSGVO erforderlich ist. Ebenso ist zu prüfen, ob ein erheblicher Cybersicherheitsvorfall nach § 34 NISG 2026 vorliegt. Der Leitfaden schweigt zu beiden Fragen, obwohl sie für Anbieter die unmittelbarsten Rechtsfolgen einer CVD-Meldung sind.

    Veraltete Darstellung des Cyber Resilience Act

    Der Leitfaden beschreibt den CRA im Futur: Anforderungen „sollen“ festgelegt werden. Tatsächlich ist der CRA seit 10. Dezember 2024 in Kraft, und seit 11. September 2026 gelten die Meldepflichten nach Art. 14. Hersteller müssen aktiv ausgenutzte Schwachstellen binnen 24 Stunden als Frühwarnung, binnen 72 Stunden als Meldung und spätestens 14 Tage nach Verfügbarkeit einer Korrektur als Abschlussbericht melden, gleichzeitig an das als Koordinator benannte CSIRT und an die ENISA über deren einheitliche Meldeplattform.

    Für die CVD-Praxis ist das entscheidend. Meldet ein Sicherheitsforschender eine Schwachstelle, die bereits aktiv ausgenutzt wird, löst das beim Hersteller eine gesetzliche Meldepflicht mit Stundenfristen aus. Der Leitfaden sollte das Zusammenspiel zwischen freiwilliger CVD-Meldung und gesetzlicher CRA-Meldung erklären und die Rolle von CERT.at in beiden Verfahren abgrenzen.

    Ab 11. Dezember 2027 müssen Hersteller außerdem ein CVD-Konzept umsetzen, eine Kontaktstelle für Schwachstellenmeldungen bereitstellen und behobene Schwachstellen veröffentlichen. Auch die Pflicht von Händlern, Hersteller über erkannte Schwachstellen unverzüglich zu informieren (Art. 20 CRA), fehlt im Leitfaden.

    Im Abkürzungsverzeichnis wird der „Cyber Security Act 2“ als Verordnung angeführt. Es handelt sich um einen Vorschlag der Kommission. Der Text sollte ihn auch so bezeichnen.

    Fehlender Bezug zur NISV 2026

    Der Leitfaden erwähnt nicht, dass er seit Oktober 2026 rechtlich relevant geworden ist. Nummer 6.10.2 lit. e im Anhang der Durchführungsverordnung (EU) 2024/2690 verlangt von den betreffenden Einrichtungen ein Verfahren für die Offenlegung von Schwachstellen im Einklang mit den geltenden nationalen Konzepten für die koordinierte Offenlegung. Durch § 2 NISV 2026 gilt das nun für alle wesentlichen und wichtigen Einrichtungen in Österreich. Das „geltende nationale Konzept“ ist dieser Leitfaden.

    Damit wird ein unverbindlich formulierter Leitfaden zum faktischen Maßstab für eine verwaltungsstrafrechtlich sanktionierte Pflicht. Einrichtungen, Prüfstellen nach § 33 NISG 2026 und das Bundesamt für Cybersicherheit brauchen deshalb klare Mindestinhalte. Abschnitt 6 behandelt diese Frage ausführlich.

    Weitere inhaltliche Lücken

    • Fehlende Normbezüge. Der Leitfaden verweist nicht auf ISO/IEC 29147 (Offenlegung von Schwachstellen) und ISO/IEC 30111 (Behandlung von Schwachstellen). Gerade für Einrichtungen, die ihr Verfahren auditieren lassen müssen, wären diese Normen der naheliegende Bezugsrahmen.
    • Keine Hinweise zu OT und Medizinprodukten. Aktive Tests an Systemen der Betriebstechnik, an Medizinprodukten oder an Fahrzeugen können physische Schäden verursachen. Der Leitfaden sollte aktive Tests an solchen Produktivsystemen ohne Vereinbarung ausdrücklich ausschließen und auf Laboruntersuchungen verweisen.
    • Priorisierung nur über CVSS. Für die Priorisierung empfiehlt der Leitfaden allein CVSS. Er sollte ergänzend auf Kataloge aktiv ausgenutzter Schwachstellen, Wahrscheinlichkeitsmodelle wie EPSS und entscheidungsorientierte Verfahren wie SSVC verweisen.
    • Keine Mustertexte. Anbieter erhalten weder eine Muster-CVD-Policy noch eine Muster-security.txt noch eine Musterformulierung für Zustimmung und Safe Harbour. Andere Staaten stellen solche Vorlagen bereit.
    • Keine Vorbildwirkung des Staates. Der Leitfaden enthält keine Selbstverpflichtung des Bundes, für seine eigenen Systeme eine CVD-Policy und security.txt zu veröffentlichen oder ein Bug-Bounty-Programm einzurichten (siehe Estland, Abschnitt 5.1).

    Kapitel zum Hinweisgeberschutz

    Das Kapitel zum HinweisgeberInnenschutzgesetz ist für die Zielgruppe weitgehend nicht einschlägig. Das HSchG schützt Personen, die im Rahmen einer beruflichen Verbindung von Rechtsverletzungen erfahren. Externe Sicherheitsforschende ohne berufliche Verbindung zum Anbieter fallen nicht darunter. Das gewählte Beispiel betrifft einen Insider in einem Energieunternehmen und keine CVD-Konstellation. Das Kapitel sollte auf eine kurze Abgrenzung reduziert werden: Wann ist das HSchG einschlägig, wann die CVD-Policy, und was gilt für Mitarbeitende, die im eigenen Unternehmen eine Schwachstelle finden?

    Redaktionelle Mängel

    FundstelleMangelVorschlag
    Inhaltsverzeichnis„Art 10 EMRK 334“ (Seitenzahl 33 mit Ziffer 4 der nächsten Zeile verschmolzen)Korrigieren
    S. 30 bis 31Die Absätze „Rollendefinition“ und „Verantwortliche“ sind wortgleich doppelt vorhanden, die Überschrift „Verantwortliche“ erscheint zweimalDublette entfernen
    S. 18„zukommen zu lassenn“„zukommen zu lassen“
    AbkürzungsverzeichnisStPO als „BGBl I 631/1975“ zitiert, die Reihe BGBl. I besteht erst seit 1997„BGBl. Nr. 631/1975“
    AbkürzungsverzeichnisCSA 2 als Verordnung bezeichnetAls Kommissionsvorschlag kennzeichnen
    Abschnitt 3.1CRA im Futur dargestelltAn die geltende Rechtslage anpassen
    Abschnitt 3.5Verweis auf §§ 36 ff DSGStreichen oder auf Behördenverarbeitung beschränken

    Internationaler Vergleich

    Estland

    Estland gilt als digitaler Vorreiter der EU. Bei der koordinierten Offenlegung von Schwachstellen ist das Bild differenzierter, und gerade das ist für Österreich lehrreich.

    Lange kein formales Verfahren. Die ENISA stellte in ihrer Bestandsaufnahme 2022 fest, dass Estland keine nationale CVD-Policy umgesetzt hatte. Schwachstellen wurden über bestehende Institutionen behandelt. Private Unternehmen und Forschung waren zwar aktiv, die Zusammenarbeit mit staatlichen Stellen war aber nicht formalisiert.

    ROCA als Wendepunkt. Den Anstoß gab die ROCA-Schwachstelle im Chip des estnischen Personalausweises. Ein internationales Forschungsteam informierte die Informationssystembehörde RIA am 30. August 2017. Betroffen waren rund 750.000 Ausweise. Die RIA hielt danach fest, dass die erwarteten Informationsquellen, internationale Meldemechanismen und Herstellerhinweise, versagt hatten, während externe Forschende die Behebung ermöglichten.

    Der Staat als Auftraggeber der Forschenden. Die Konsequenz war kein Gesetz, sondern Praxis. 2022 startete die RIA ein eigenes Bug-Bounty-Programm für staatliche Systeme, abgewickelt über die Plattform HackerOne, mit Prämien von bis zu 3.000 Euro für kritische Schwachstellen. Bis Anfang 2024 gingen rund 11.000 Meldungen ein, davon 7.859 im Jahr 2023, mehr als die Hälfte zu Cross-Site-Scripting. Parallel schloss die RIA im Frühjahr 2022 einen Vertrag über kontinuierliches Red Teaming und baute ein eigenes Red Team auf, das nach eigenen Angaben in das Netz jeder geprüften Institution eindringen konnte.

    Rechtsrahmen nach NIS2. Estland hat NIS2 durch eine Novelle des Küberturvalisuse seadus (Cybersicherheitsgesetz) umgesetzt, die am 1. Jänner 2026 in Kraft trat. Die RIA übernimmt danach die Aufgaben des CVD-Koordinators nach Art. 12 Abs. 1 NIS-2-Richtlinie. Das Gesetz erlaubt ihr ausdrücklich, Diensteanbieter und andere Personen über Schwachstellen zu informieren, und sie führt ein Register, in das auch Schwachstellen eingetragen werden. Die Risikomanagementpflichten werden in einer Verordnung konkretisiert, die sich am nationalen Informationssicherheitsstandard E-ITS orientiert. CERT-EE ist seit 2006 aktiv, rund um die Uhr besetzt und war 2017 die fünfte Organisation weltweit mit SIM3-Zertifizierung.

    Kein gesetzlicher Safe Harbour. Das estnische Strafgesetzbuch stellt in § 217 die unrechtmäßige Erlangung von Zugang zu Computersystemen durch Beseitigung oder Umgehung von Schutzmaßnahmen unter Strafe. Eine besondere Ausnahme für Sicherheitsforschende ist nicht ersichtlich. Die estnische Polizei verweist auf legale Wege über Vermittlungsplattformen und Arbeitgeber, die solche Tätigkeiten offiziell bezahlen.

    Bewertung. Estlands Stärke liegt nicht im Recht, sondern in der Haltung. Der Staat betrachtet externe Forschende als Ressource, bezahlt sie und lässt die eigenen Systeme laufend angreifen. Für Österreich folgt daraus: Die rechtliche Absicherung sollte sich an Belgien orientieren, die staatliche Praxis an Estland. Ein Bug-Bounty-Programm für die IKT des Bundes und kontinuierliche Angriffssimulationen für Bundesbehörden würden die Glaubwürdigkeit der Nationalen CVD-Policy erheblich stärken.

    Belgien

    Belgien hat seit 15. Februar 2023 einen gesetzlichen Rahmen für ethisches Hacking. Er ist heute in Art. 22 und 23 des belgischen NIS2-Gesetzes vom 26. April 2024 geregelt. Natürliche und juristische Personen, die ohne betrügerische oder schädigende Absicht handeln, dürfen Schwachstellen in Netz- und Informationssystemen in Belgien untersuchen und melden, wenn sie strenge Bedingungen einhalten:

    • Verhältnismäßigkeit der Handlungen,
    • vereinfachte Meldung an die betroffene Organisation und das Centre for Cybersecurity Belgium (CCB) binnen 24 Stunden,
    • vollständige Meldung binnen 72 Stunden,
    • keine Veröffentlichung ohne Zustimmung des CCB.

    Der Schutz gilt unabhängig davon, ob die betroffene Organisation selbst unter NIS2 fällt. Er schützt vor straf- und zivilrechtlicher Verfolgung, begründet aber keinen Anspruch auf Entlohnung. Mit „Hack the Government 2024“ hat die belgische Bundesregierung den Rahmen auch öffentlich mit Leben erfüllt.

    Das belgische Modell zeigt, dass eine gesetzliche Safe-Harbour-Regelung im Rahmen der NIS2-Umsetzung möglich ist, ohne „Hacking“ allgemein straffrei zu stellen. Die Meldefristen von 24 und 72 Stunden sind ambitioniert, sie sichern aber zugleich, dass Funde nicht gehortet werden.

    Niederlande

    Die Niederlande verfügen über keine gesetzliche Ausnahme, aber über eine veröffentlichte Strafverfolgungsrichtlinie der Staatsanwaltschaft (Openbaar Ministerie). Erstattet eine Organisation ohne eigene CVD-Policy Anzeige gegen einen ethischen Hacker, ist das für die Staatsanwaltschaft kein Grund, diesen unmittelbar als Verdächtigen zu führen. Bei der Entscheidung über eine Verfolgung wiegt der Beitrag der CVD zu einer sicheren digitalen Welt schwer. Ergänzend gibt das Nationale Cyber Security Centrum (NCSC) einen Leitfaden heraus, der mit Staatsanwaltschaft und Polizei abgestimmt ist.

    Der österreichische Erlass des BMJ vom 23. August 2023 geht in eine ähnliche Richtung. Er ist jedoch kaum bekannt und nicht als öffentliche Verfolgungsrichtlinie gestaltet. Er sollte als eigenständige, laufend aktualisierte Richtlinie veröffentlicht und im Leitfaden prominent verlinkt werden.

    Überblick

    KriteriumÖsterreichEstlandBelgienNiederlande
    CVD-Koordinatornationales CSIRT (CERT.at) nach § 11 NISG 2026RIA nach Cybersicherheitsgesetz (seit 1.1.2026)CCB nach NIS2-GesetzNCSC
    Strafrechtlicher Schutzkein gesetzlicher Safe Harbour, Schutz über Absichtserfordernis und Ermächtigungsdelikt des § 118a StGBkein gesetzlicher Safe Harbourgesetzlicher Safe Harbour unter strengen Bedingungen (Art. 22 f NIS2-Gesetz)kein gesetzlicher Safe Harbour, veröffentlichte Verfolgungsrichtlinie
    Staatliche Praxiskeine bundesweite Bug-Bounty-Praxis bekanntBug-Bounty-Programm der RIA seit 2022, kontinuierliches Red Teaming„Hack the Government“, CVD-Policy des CCBetablierte CVD-Kultur in Verwaltung und Wirtschaft
    BesonderheitLeitfaden ist seit NISV 2026 faktischer PrüfmaßstabStärke in der Umsetzung, nicht im RechtMeldepflicht an CCB binnen 24 bzw. 72 StundenLeitfaden mit Staatsanwaltschaft abgestimmt

    CVD-Pflicht für alle NIS-2-Einrichtungen

    Die Pflicht besteht bereits

    Die Frage, ob man jede NIS-2-pflichtige Einrichtung zu einem CVD-Verfahren verpflichten könnte, ist nach geltendem Recht im Grundsatz bereits beantwortet. Die Kette der Normen lautet:

    1. Art. 21 Abs. 2 lit. e NIS-2-Richtlinie verlangt Sicherheitsmaßnahmen einschließlich des Umgangs mit Schwachstellen und deren Offenlegung.
    2. § 32 Abs. 4 lit. e NISG 2026 setzt dies wortgleich um: „einschließlich Management und Offenlegung von Schwachstellen“.
    3. § 32 Abs. 5 NISG 2026 ermächtigt die Cybersicherheitsbehörde, nähere Anforderungen festzulegen und Durchführungsrechtsakte der Kommission auf weitere Sektoren zu erstrecken.
    4. § 2 NISV 2026 erklärt den Anhang der Durchführungsverordnung (EU) 2024/2690 auf alle wesentlichen und wichtigen Einrichtungen der Anlagen 1 und 2 NISG 2026 für anwendbar.
    5. Nummer 6.10.2 lit. e dieses Anhangs verpflichtet dazu, ein Verfahren für die Offenlegung von Schwachstellen im Einklang mit den geltenden nationalen Konzepten für die koordinierte Offenlegung festzulegen.

    Diese Anforderung ist, anders als etwa die Schwachstellen-Scans in lit. b, nicht unter den Vorbehalt „soweit angemessen“ gestellt. Kann eine Einrichtung ihr aufgrund ihrer Größe oder vorübergehend nicht entsprechen, muss sie nach § 4 NISV 2026 kompensierende Maßnahmen setzen, begründet dokumentieren und jährlich auf ihre Wirksamkeit prüfen. Ein vollständiger Verzicht ist damit nicht vorgesehen. Ausgenommen sind lediglich Einrichtungen, für die sektorspezifisches Unionsrecht mit gleichwertigem Niveau gilt (§ 27 NISG 2026), insbesondere Finanzunternehmen unter DORA.

    Seit Anfang Oktober 2026 sind damit grob geschätzt rund 5.000 Einrichtungen in Österreich verpflichtet, ein CVD-Verfahren festzulegen. Die Pflicht ist Teil der Risikomanagementmaßnahmen, deren Umsetzung in der Selbstdeklaration binnen zwölf Monaten ab Registrierung darzulegen ist. Verstöße sind nach dem NISG 2026 mit Geldstrafen bedroht.

    Offene Auslegungsfragen

    Die bestehende Pflicht hat drei Schwächen.

    Was ist „ein Verfahren für die Offenlegung“? Der Wortlaut lässt offen, ob nur die Offenlegung eigener Erkenntnisse oder auch die Entgegennahme externer Meldungen gemeint ist. Teleologisch und im Licht von Art. 12 NIS-2-Richtlinie sowie der technischen Umsetzungsleitlinien der ENISA ist die Entgegennahme und Koordination externer Meldungen eingeschlossen. Ein Offenlegungsverfahren ohne Eingangskanal wäre sinnlos. Eine Klarstellung durch das Bundesamt für Cybersicherheit wäre dennoch geboten.

    Muss das Verfahren öffentlich sein? Eine Veröffentlichungspflicht ist nicht ausdrücklich vorgesehen. Ein Meldekanal, den Außenstehende nicht finden, verfehlt aber seinen Zweck. Mindestens die Kontaktadresse sollte maschinenlesbar über security.txt nach RFC 9116 auffindbar sein.

    Was heißt „im Einklang mit den nationalen Konzepten“? Der Verweis macht den Leitfaden zum Prüfmaßstab. Er enthält aber keine prüffähigen Mindestinhalte. Prüfstellen nach § 33 NISG 2026 und das Bundesamt werden daher uneinheitlich beurteilen, was genügt. Das ist der stärkste Grund, die in Abschnitt 4 genannten Mängel rasch zu beheben.

    Regelungsoptionen

    Wir sehen vier Optionen, die einander ergänzen und nicht ausschließen.

    Option A: Klarstellung durch das Bundesamt für Cybersicherheit. Eine Leitlinie oder ein Prüfkatalog zur Selbstdeklaration legt fest, was ein CVD-Verfahren nach Nummer 6.10.2 lit. e mindestens enthalten muss. Diese Option ist ohne Rechtsänderung sofort umsetzbar. Sie wirkt aber nur als Auslegungshilfe.

    Option B: Ergänzung der NISV 2026. Die Cybersicherheitsbehörde kann auf Grundlage von § 32 Abs. 5 NISG 2026 eine eigene Bestimmung über die koordinierte Offenlegung in die NISV aufnehmen. Sie würde die Mindestinhalte verbindlich festlegen. Die Verordnungsermächtigung trägt das, weil es um „nähere Anforderungen an die Risikomanagementmaßnahmen“ geht.

    Option C: Gesetzliche Regelung im NISG 2026 und im StGB. Nur der Gesetzgeber kann einen echten Safe Harbour nach belgischem Vorbild schaffen und die CVD-Kommunikation beim Koordinator unter Beschlagnahmeschutz stellen. Eine solche Regelung sollte, wie in Belgien, unabhängig davon gelten, ob die betroffene Organisation selbst unter das NISG fällt. Damit würde zugleich der zweite Punkt der Entschließung des Nationalrats erfüllt.

    Option D: Erweiterung über den NIS-2-Anwendungsbereich hinaus. Für Gemeinden, ausgegliederte Rechtsträger und Auftragnehmer der öffentlichen Hand außerhalb des NISG könnte eine öffentlich erreichbare CVD-Policy über Vergabe- und Förderbedingungen eingefordert werden. Für Hersteller regelt der CRA ab Dezember 2027 eine eigene Pflicht.

    Vorgeschlagene Mindestinhalte

    Für Option A oder B schlagen wir folgende Mindestinhalte vor:

    ElementMindestanforderung
    Auffindbarkeitsecurity.txt nach RFC 9116 unter jeder öffentlich genutzten Domain, mit Kontaktadresse, Ablaufdatum und Verweis auf die Policy
    GeltungsbereichBeschreibung der umfassten und ausgeschlossenen Systeme, ausdrücklicher Ausschluss aktiver Tests an OT-Produktivsystemen ohne Vereinbarung
    VerhaltensregelnMindestens die Grundprinzipien der Nationalen CVD-Policy
    Zustimmung und Safe HarbourZustimmung zur Untersuchung im definierten Rahmen, Zusage, keine Ermächtigung nach § 118a Abs. 3 StGB zu erteilen, Verzicht auf zivilrechtliche Ansprüche bei richtlinienkonformem Handeln
    FristenEingangsbestätigung binnen 5 Werktagen, Erstbewertung binnen 14 Tagen, Standardfrist bis zur Offenlegung 90 Tage
    KoordinationEinbindung von CERT.at bei mehreren betroffenen Anbietern oder Staaten, Weiterleitung von Funden in Drittprodukten an den Hersteller
    IntegrationVerknüpfung mit Patch-, Änderungs-, Risiko- und Vorfallsmanagement (Nummer 6.10.2 lit. d), Prüfung von Meldepflichten nach Art. 33 DSGVO und § 34 NISG 2026
    Kleine EinrichtungenZulässige kompensierende Maßnahme: Meldekanal über einen beauftragten Dienstleister mit dokumentierter Weiterleitung, sofern die übrigen Inhalte gewahrt sind

    Einwände und Bewertung

    Aufwand. Eine security.txt, ein überwachtes Postfach und ein beschriebener Ablauf verursachen geringe Kosten. Die eigentliche Arbeit, Schwachstellen zu bewerten und zu beheben, müssen Einrichtungen nach § 32 NISG 2026 ohnehin leisten.

    Flut minderwertiger Meldungen. Die Sorge ist berechtigt, wie der Leitfaden selbst einräumt. Sie spricht für klare Regeln zu nicht relevanten Befunden, für Triage durch Dienstleister oder Plattformen und für die Möglichkeit, offensichtlich automatisierte Meldungen ohne Verifikation knapp zu beantworten. Gegen eine Pflicht spricht sie nicht.

    „Einladung an Angreifer“. Angreifer brauchen keine Einladung. Eine CVD-Policy ändert nichts an der Angriffsfläche, sie schafft nur einen Kanal für diejenigen, die eine gefundene Schwachstelle melden wollen.

    Haftung. Einrichtungen fürchten, durch eine Policy Rechte aus der Hand zu geben. Der Verzicht gilt aber nur für richtlinienkonformes Verhalten, also für Handlungen, die der Einrichtung nützen.

    Kritische Infrastruktur und OT. Hier ist Zurückhaltung geboten. Die Lösung liegt im Geltungsbereich: Meldungen bleiben erwünscht, aktive Tests an Produktivsystemen sind ohne Vereinbarung ausgeschlossen.

    Ergebnis. Eine Pflicht zu einem CVD-Verfahren für alle NIS-2-Einrichtungen ist rechtlich nicht nur möglich, sie besteht seit der NISV 2026 bereits. Was fehlt, sind verbindliche Mindestinhalte, eine einheitliche Prüfpraxis und die rechtliche Absicherung derjenigen, die das Verfahren nutzen sollen. Ohne Safe Harbour bleibt eine CVD-Pflicht ein Briefkasten, in den sich niemand traut, etwas einzuwerfen.

    Empfehlungen

    1. Gesetzlicher Safe Harbour. BMJ und BMI sollten den zweiten Punkt der Entschließung vom 21. Jänner 2026 umsetzen und eine Regelung nach dem Vorbild von Art. 22 und 23 des belgischen NIS2-Gesetzes vorlegen. Sie sollte alle bei der Schwachstellensuche typischerweise berührten Tatbestände erfassen und nicht nur § 118a StGB.
    2. Schutz der CVD-Kommunikation. Kommunikation mit dem CVD-Koordinator sollte einem gesetzlichen Beschlagnahme- und Verwertungsverbot unterliegen, mit eng begrenzten Ausnahmen.
    3. Transparenter Abwägungsprozess. Für das Zurückhalten von Schwachstellen durch staatliche Stellen braucht es einen gesetzlich geregelten Vulnerabilities Equities Process mit Offenlegungsvermutung, Befristung, unabhängiger Kontrolle und Bericht an den Nationalrat. Daten aus der CVD-Koordination dürfen nicht für offensive Zwecke genutzt werden.
    4. Mindestinhalte nach NISV 2026. Das Bundesamt für Cybersicherheit sollte die Mindestinhalte eines CVD-Verfahrens nach Nummer 6.10.2 lit. e festlegen, zunächst als Leitlinie und mittelfristig in der NISV.
    5. Ausgewogene Fristen. Standardfrist 90 Tage, Verlängerung für Hardware und OT bis 180 Tage mit Zwischenmaßnahmen, Offenlegungsrecht der Meldenden nach Fristablauf und Vorankündigung.
    6. Überarbeitung des Datenschutzkapitels. Rechtsgrundlage Art. 6 Abs. 1 lit. f DSGVO mit Erwägungsgrund 49, Streichung der Verweise auf Auftragsverarbeitung bei unbeauftragter Forschung und auf §§ 36 ff DSG, Ergänzung um Art. 33 und 34 DSGVO sowie § 34 NISG 2026.
    7. Aktualisierung des CRA-Kapitels. Darstellung der geltenden Meldepflichten nach Art. 14, des Zusammenspiels mit der CVD-Meldung, der Rolle von CERT.at, der ab Dezember 2027 geltenden Herstellerpflichten und der Händlerpflichten nach Art. 20.
    8. Mustervorlagen. Veröffentlichung einer Muster-CVD-Policy mit Safe-Harbour-Klausel und einer Muster-security.txt, ergänzt um eine Empfehlung, die Nicht-Erteilung der Ermächtigung nach § 118a Abs. 3 StGB zuzusagen.
    9. Vorbildwirkung des Bundes. Veröffentlichung von CVD-Policies und security.txt für alle Bundesdienststellen sowie ein Bug-Bounty-Programm und kontinuierliche Angriffssimulationen für die IKT des Bundes nach estnischem Vorbild.
    10. Verfolgungsrichtlinie. Veröffentlichung des BMJ-Erlasses von 2023 als eigenständige, aktualisierte Verfolgungsrichtlinie nach niederländischem Vorbild.
    11. Normen und OT. Verweise auf ISO/IEC 29147 und 30111, Ergänzung um EPSS, SSVC und Kataloge ausgenutzter Schwachstellen, ausdrückliche Regeln für OT, Medizinprodukte und Fahrzeuge.
    12. Redaktion. Behebung der in Abschnitt 4.10 aufgelisteten Mängel.

    Hinweise für Einrichtungen

    Unabhängig von einer Überarbeitung des Leitfadens sollten wesentliche und wichtige Einrichtungen jetzt handeln, weil die Pflicht nach Nummer 6.10.2 lit. e Anhang DVO 2024/2690 in Verbindung mit § 2 NISV 2026 bereits gilt. Wir empfehlen:

    • Veröffentlichung. Eine eigene CVD-Policy und eine security.txt veröffentlichen, mit ausdrücklicher Zustimmung zur Untersuchung im definierten Rahmen, Zusage der Nicht-Erteilung der Ermächtigung nach § 118a Abs. 3 StGB und Verzicht auf zivilrechtliche Ansprüche bei richtlinienkonformem Verhalten.
    • Integration. Das Verfahren in Vorfalls-, Patch- und Datenschutzprozesse einbinden, insbesondere die Prüfung von Meldepflichten nach Art. 33 DSGVO und § 34 NISG 2026.
    • Dokumentation. Das Verfahren in der Selbstdeklaration nach NISG 2026 dokumentieren.
    • Hersteller. Hersteller von Produkten mit digitalen Elementen müssen zusätzlich die seit 11. September 2026 geltenden CRA-Meldepflichten erfüllen.

    Quellen

  • Wenn Datenschutz zur Straftat wird: Der Präzedenzfall GrapheneOS

    Wenn Datenschutz zur Straftat wird: Der Präzedenzfall GrapheneOS

    Ein Smartphone-Feature, das ursprünglich entwickelt wurde, um die sensibelsten Daten von Nutzern zu schützen, bringt nun einen US-Bürger vor Gericht. Es ist der erste bekannte Fall in den USA, bei dem eine Person strafrechtlich belangt wird, weil sie eine spezifische IT-Sicherheitsfunktion genutzt hat. Dieser Präzedenzfall wirft eine grundlegende Frage auf: Wo endet das legitime Recht auf digitale Privatsphäre und wo beginnt die illegale Vernichtung von Beweismitteln?

    Was genau ist passiert?

    Der Vorfall ereignete sich am 24. Januar 2025 bei einer Grenzkontrolle am Flughafen in Atlanta.

    • Die Person: Der US-Bürger Samuel Tunick befand sich auf der Rückreise aus seinem Urlaub in der Dominikanischen Republik.
    • Die Kontrolle: Beamte der US-Grenzschutzbehörde (CBP) verlangten die Herausgabe und Entsperrung seines Google Pixel Smartphones. Das Gerät lief mit dem stark datenschutzfokussierten Open-Source-Betriebssystem GrapheneOS.
    • Die Technologie: Anstatt seines regulären Entsperrcodes gab Tunick ein spezielles Notfall-Passwort, eine sogenannte „Duress PIN“, ein.
    • Die Folge: Diese Funktion entsperrt das Gerät nicht. Stattdessen werden unwiderruflich alle darauf gespeicherten Nutzerdaten gelöscht.
    • Die Anklage: Das US-Justizministerium erhob im November 2025 Anklage gegen Tunick. Der Vorwurf lautet auf Vernichtung von Eigentum zur Verhinderung einer behördlichen Beschlagnahme, was im US-Recht als Behinderung der Justiz (Obstruction of Justice) gewertet werden kann.

    Die Perspektive der Cybersicherheit

    Aus technischer Sicht ist die Implementierung einer „Duress PIN“ ein konsequenter Schritt zur Absicherung hochsensibler Informationen. Betriebssysteme wie GrapheneOS richten sich gezielt an Journalisten, Aktivisten oder Sicherheitsexperten, bei denen ein unbefugter Datenzugriff eine reale Gefahr für sie selbst oder ihre Quellen darstellen könnte.

    Sicherheitsaspekte von Notfall-Löschfunktionen:

    • Schutz vor physischem Zwang: Die Funktion schützt Nutzer, die unter Androhung von Gewalt, Erpressung oder Repressalien zur Herausgabe ihres Passworts gezwungen werden.
    • Unauffällige Ausführung: Es gibt auf dem Bildschirm keinen sichtbaren Hinweis darauf, dass gerade eine Löschung stattfindet; das Gerät startet nach der Eingabe lediglich neu. Dies schützt den Nutzer in akuten Gefahrensituationen.
    • Kryptografische Sicherheit: Nach der Eingabe der PIN sind die Daten permanent und unwiderruflich vernichtet.

    Wenn Strafverfolgungsbehörden argumentieren, dass allein die Nutzung einer solchen Software verdächtig sei, gefährdet dies das legitime Bedürfnis nach maximaler IT-Sicherheit. Organisationen wie die Electronic Frontier Foundation (EFF) warnen davor, dass Technologien, die für Privatsphäre und Sicherheit entwickelt wurden, dazu führen könnten, dass ihre Nutzer pauschal als Kriminelle behandelt werden.

    Die menschenrechtliche Dimension

    Der Fall Tunick zeigt eindrücklich die rechtlichen Grauzonen bei Grenzkontrollen auf. Die US-Behörden haben die Durchsuchungen mobiler Endgeräte massiv ausgeweitet: Im Haushaltsjahr 2025 wurden über 55.000 Geräte an den Grenzen kontrolliert – ein Anstieg von 33 Prozent gegenüber dem Jahr 2023. An der Grenze gelten oft reduzierte rechtliche Hürden für Durchsuchungen, was Menschenrechtler zunehmend kritisieren.

    Kritische Faktoren im aktuellen Fall:

    • Fehlender Durchsuchungsbeschluss: Die Grenzbeamten besaßen für die Kontrolle des Smartphones keinen richterlichen Durchsuchungsbeschluss und verlangten das Passwort unter Androhung der sofortigen Beschlagnahmung.
    • Verweigerter Rechtsbeistand: Den Berichten der Verteidigung zufolge ignorierten die Behörden mehrfache Bitten Tunicks, einen Anwalt hinzuzuziehen – er soll viermal erfolglos nach seinem rechtlichen Beistand gefragt haben.
    • Politisches Profiling: Die Anwälte des Angeklagten argumentieren, Tunick sei gezielt wegen seiner mutmaßlichen Verbindungen zur Umwelt- und Protestbewegung „Defend the Atlanta Forest“ (bekannt durch die Proteste gegen das Ausbildungszentrum „Cop City“) ins Visier genommen worden. Die angebliche Suche nach illegalem Material sei lediglich ein Vorwand gewesen.

    Konfliktlinien: Sicherheit vs. Bürgerrechte

    AspektBehördliche SichtBürgerrechtliche Sicht
    BeweissicherungDie aktive Löschung von Daten durch den Nutzer verhindert legitime Ermittlungen und stellt eine illegale Beweismittelvernichtung dar.Ohne einen richterlichen Beschluss stellt die erzwungene Durchsuchung eines Smartphones einen unverhältnismäßigen Eingriff in die verbrieften Verfassungsrechte dar.
    GrenzschutzAn Landesgrenzen sind erweiterte Kontrollrechte zur Wahrung der nationalen Sicherheit unverzichtbar.Auch an einer Landesgrenze dürfen grundlegende konstitutionelle Rechte und der Zugang zu rechtlichem Beistand nicht willkürlich ausgesetzt werden.
    TechnologienutzungSpezielle Privacy-Betriebssysteme und Löschfunktionen können Kriminellen helfen, ihre Spuren gezielt zu verwischen.Privatsphäre ist ein Grundrecht. Mechanismen zum digitalen Selbstschutz dürfen nicht per se kriminalisiert werden.

    Fazit und Ausblick

    Das zuständige Bundesgericht in den USA plant, voraussichtlich Ende Oktober 2026 über einen Antrag der Verteidigung auf Beweisunterdrückung zu entscheiden. Dieses Urteil könnte wegweisend sein und festlegen, wie datenschutzfreundliche Technologien künftig an US-Grenzen juristisch behandelt werden.

    Für die Cybersicherheit und die Menschenrechte steht viel auf dem Spiel: Wird der Einsatz legitimer, datenschutzfreundlicher Technologien an sich kriminalisiert, verliert die Zivilgesellschaft ein wichtiges und oft lebensrettendes Werkzeug zum Schutz ihrer digitalen Unversehrtheit. Der Fall Samuel Tunick wird somit zur Nagelprobe dafür, ob in einer digitalisierten Welt das Recht auf informationelle Selbstbestimmung auch dann Bestand hat, wenn staatliche Behörden anklopfen.

  • Halbwissen mal LLM

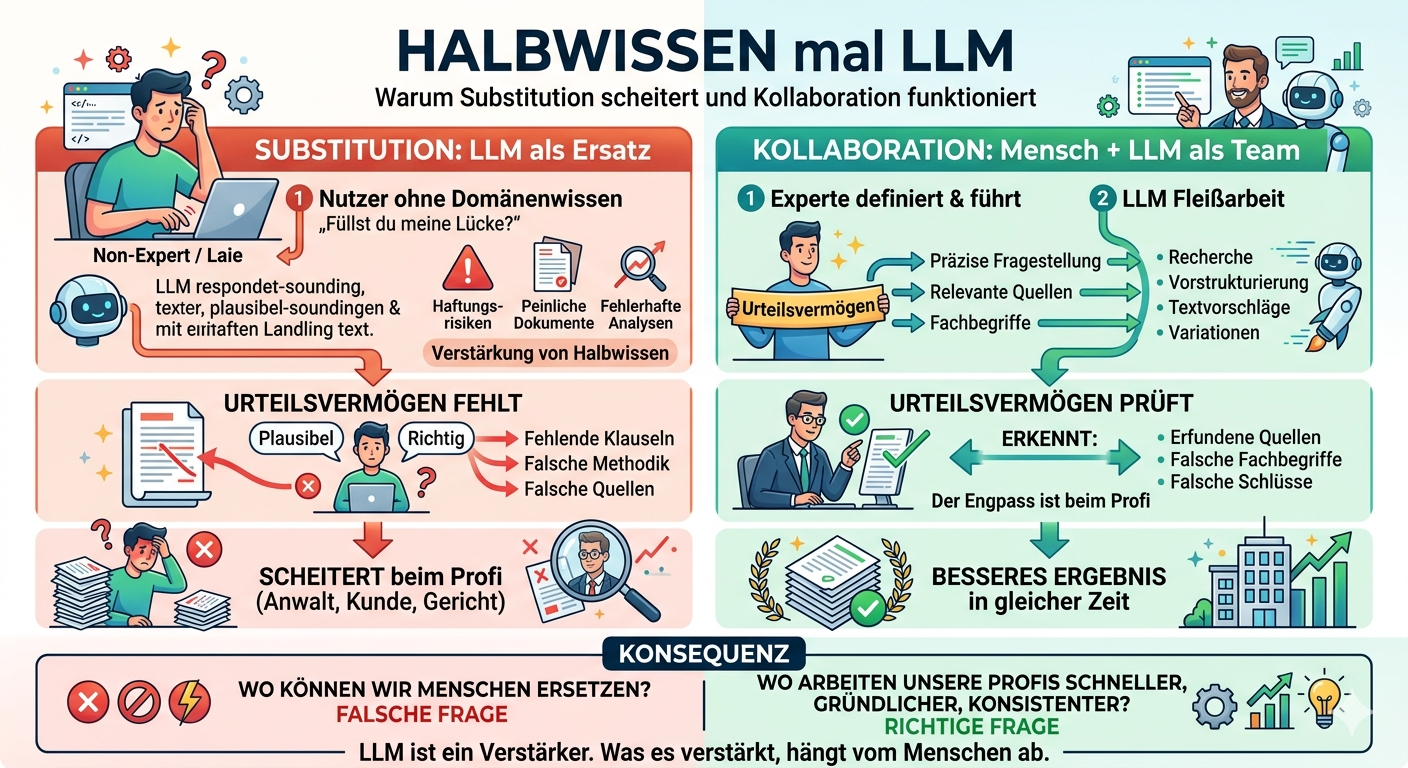
    Halbwissen mal LLM

    *Warum Substitution scheitert und Kollaboration funktioniert*

    Zwei Dinge fallen auf, wenn man Menschen beim Einsatz von Large Language Models über die Schulter schaut. Das eine ist die Geschwindigkeit, mit der gute Ergebnisse entstehen, wenn ein Profi mit einem LLM arbeitet. Das andere ist die Geschwindigkeit, mit der Unsinn produziert wird, wenn jemand das LLM als Ersatz für Expertise einsetzt, die er nicht hat. Der Unterschied ist nicht graduell, sondern kategorisch.

    Das Muster

    Der Mediziner fragt das LLM nach juristischer Bewertung eines Falls und dilettiert mit der Antwort herum. Der Vertriebsmitarbeiter lässt sich technische Details für ein Angebot ausarbeiten, das er anschließend verteidigen muss. Die Marketing-Abteilung produziert Code, ohne ihn lesen zu können. Der Manager erstellt Strategiepapiere zu Themen, deren Vokabular er bei der Gelegenheit zum ersten Mal hört. Das Muster ist immer dasselbe: Jemand verwendet das LLM, um eine Lücke zu füllen, die er selbst nicht erkennen kann, weil er die Domäne nicht kennt.

    Diese Ansätze scheitern. Nicht immer sofort, nicht immer sichtbar. Aber sie scheitern in dem Moment, in dem das Ergebnis auf einen Profi der Domäne trifft. Spätestens beim Anwalt, beim Auditor, beim Kunden, beim Gericht.

    Warum es scheitert

    Ein LLM ist kein Wissensspeicher mit Wahrheitsanspruch. Es ist eine Maschine, die plausibel klingenden Text produziert. Plausibel bedeutet: stimmig im Tonfall, passend in der Struktur, korrekt in der Grammatik, anschlussfähig an das, was vorher kam. Plausibel bedeutet nicht: richtig.

    Wer in einer Domäne arbeitet, kann diesen Unterschied erkennen. Er liest einen Vertragstext und sieht die fehlende Klausel. Er liest einen Penetrationstestbericht und erkennt, dass die Klassifizierung nicht zur Methodik passt. Er liest die Erläuterung einer Compliance-Anforderung und merkt, dass die Quelle daneben liegt. Wer in der Domäne nicht zu Hause ist, hat genau dieses Werkzeug nicht. Er sieht plausibel und liest richtig.

    Das Resultat ist eine systematische Verstärkung von Halbwissen. Das LLM macht aus einem unklaren Gedanken einen klar formulierten Text. Der Text wirkt fundierter, als der zugrunde liegende Gedanke es ist. Der Nutzer hält die Verbesserung der Form für eine Verbesserung des Inhalts. Genau hier entsteht der Schaden.

    Was funktioniert

    Was hingegen ausgezeichnet funktioniert, ist die Konstellation aus erfahrenem Profi und LLM, die gemeinsam ein Werk erstellen. Der Profi bringt das Urteilsvermögen, das LLM die Recherche, die Vorstrukturierung, das Texten. Die Aufgaben verteilen sich klar.

    Der Profi definiert die Fragestellung präzise. Er kennt die relevanten Quellen, die richtigen Begriffe, die übliche Argumentationsstruktur seiner Domäne. Er weiß, was im Ergebnis stehen muss und was darin nichts verloren hat. Das LLM übernimmt die Fleißarbeit: Es liest Material, schlägt Formulierungen vor, hält den roten Faden, variiert den Ton, fügt Querverweise zusammen. Der Profi prüft jeden Schritt. Er erkennt sofort, wenn das LLM eine Quelle erfindet, einen Fachbegriff falsch verwendet, eine Schlussfolgerung zieht, die nicht trägt. Diese Erkennung ist der Engpass im gesamten Prozess. Sie liegt beim Profi und nirgendwo sonst.

    Das Ergebnis ist messbar besser als das, was der Profi alleine in der gleichen Zeit liefern würde. Und es ist um Größenordnungen besser als das, was ein Laie mit demselben LLM produziert. Nicht weil das Werkzeug ein anderes wäre, sondern weil der Engpass ein anderer ist.

    Konsequenz

    Wer den Einsatz von LLMs in seiner Organisation plant, sollte die Frage nicht stellen als „Wo können wir Menschen ersetzen?“, sondern als „Wo haben wir Profis, die durch ein LLM schneller, gründlicher und konsistenter arbeiten können?“ Die zweite Frage führt zu Produktivitätsgewinnen. Die erste führt zu peinlichen Dokumenten, fehlerhaften Analysen und Haftungsrisiken.

    Die Trennlinie verläuft nicht zwischen Branchen, Tätigkeiten oder Senioritätsstufen. Sie verläuft zwischen Domänenkompetenz und ihrer Abwesenheit. Ein LLM ist ein Verstärker. Was es verstärkt, hängt vom Menschen ab, der es bedient.

  • Wie KI-Sprachmodelle wirklich funktionieren

    Wie KI-Sprachmodelle wirklich funktionieren

    Warum diese Maschinen brillant und gleichzeitig erstaunlich dumm sein können


    Künstliche Intelligenz schreibt Gedichte, fasst Verträge zusammen und beantwortet komplexe Fragen – aber sie scheitert an einem simplen Kreuzworträtsel. Wie kann das sein? Um das zu verstehen, müssen wir uns ansehen, was hinter den Kulissen eines sogenannten Large Language Model (LLM) tatsächlich passiert.

    Was steckt in der Maschine?

    Ein LLM wie ChatGPT oder Claude ist im Kern ein mathematisches Modell mit Milliarden von Zahlenwerten – sogenannten Parametern. Man kann sich das vorstellen wie ein riesiges Netz aus Knotenpunkten, die miteinander verbunden sind. Jede Verbindung hat eine bestimmte Stärke, ausgedrückt als Zahl. Diese Zahlen bestimmen, wie das Modell auf eine Eingabe reagiert.

    Aber woher kommen diese Zahlen?

    Das Training: Lesen lernen im Schnelldurchlauf

    Phase 1: Das Internet als Schulbuch

    Bevor ein LLM auch nur ein einziges Wort erzeugen kann, muss es trainiert werden. Dafür wird dem Modell eine gewaltige Menge an Text vorgelegt – Bücher, Webseiten, wissenschaftliche Artikel, Forenbeiträge, Nachrichtenartikel. Wir sprechen von Hunderten Milliarden Wörtern.

    Das Modell liest diese Texte aber nicht so, wie wir das tun. Es zerlegt den Text in kleine Bruchstücke, sogenannte Tokens. Ein Token ist dabei nicht unbedingt ein ganzes Wort. Das Wort „Unabhängigkeitserklärung” wird beispielsweise in mehrere Tokens zerlegt – etwa „Unab”, „hängig”, „keits”, „erklärung”. Kurze, häufige Wörter wie „der” oder „ist” sind hingegen jeweils ein eigenes Token.

    Dieser Punkt ist wichtig, und wir werden darauf zurückkommen.

    Phase 2: Das Ratespiel

    Das eigentliche Training funktioniert nach einem verblüffend einfachen Prinzip: Das Modell bekommt den Anfang eines Satzes und muss das nächste Token vorhersagen.

    Nehmen wir den Satz: „Die Hauptstadt von Österreich ist …”

    Am Anfang des Trainings rät das Modell völlig zufällig. Es könnte „Banane” vorhersagen. Das ist offensichtlich falsch. Das Trainingsverfahren berechnet nun, wie weit die Vorhersage vom tatsächlichen nächsten Wort entfernt war, und passt die Milliarden von Parametern ein winziges Stück an – so, dass „Wien” beim nächsten Mal etwas wahrscheinlicher wird.

    Diesen Vorgang wiederholt das Modell Billionen Mal, mit Billionen verschiedenen Textausschnitten. Stück für Stück lernt es dabei die Muster und Strukturen der menschlichen Sprache: Grammatik, Fakten, Argumentationsweisen, Schreibstile und sogar so etwas wie gesunden Menschenverstand.

    Phase 3: Feinschliff durch Menschen

    Nach diesem Grundtraining kann das Modell zwar Texte fortsetzen, aber es ist noch kein hilfreicher Assistent. Es würde auf die Frage „Was ist die Hauptstadt von Österreich?” nicht unbedingt mit „Wien” antworten, sondern vielleicht einfach weitere Fragen generieren – weil es in seinen Trainingsdaten häufig gesehen hat, dass auf eine Frage eine weitere folgt.

    Deshalb folgt ein zweiter Trainingsschritt: Menschliche Trainer bewerten die Antworten des Modells. Sie zeigen ihm, welche Antworten hilfreich, korrekt und sicher sind – und welche nicht. Durch dieses Feedback lernt das Modell, sich wie ein nützlicher Gesprächspartner zu verhalten, statt einfach nur Text weiterzuspinnen.

    Im Einsatz: Wie eine Antwort entsteht

    Wenn Sie einem LLM eine Frage stellen, passiert Folgendes:

    Ihre Eingabe wird in Tokens zerlegt. Diese Tokens wandern durch das neuronale Netz – durch Hunderte Schichten von Berechnungen. Am Ende steht eine Wahrscheinlichkeitsverteilung: Das Modell berechnet für jedes Token in seinem Wortschatz, wie wahrscheinlich es als nächstes kommt.

    Dann wird ein Token ausgewählt – und der Vorgang beginnt von vorne. Das gerade erzeugte Token wird an die bisherige Sequenz angehängt, und das Modell berechnet das nächste. Wort für Wort, Token für Token, entsteht so die Antwort.

    Das bedeutet: Ein LLM plant seine Antwort nicht im Voraus. Es hat keinen fertigen Gedanken im Kopf, den es dann formuliert. Es erzeugt jeden Textbaustein einzeln, immer nur auf Basis dessen, was bisher dasteht. Es ist, als würde jemand einen Roman schreiben, ohne die Handlung zu kennen – Satz für Satz, immer nur mit Blick auf das bisher Geschriebene.

    Was LLMs bemerkenswert gut können

    Trotz dieses scheinbar simplen Mechanismus sind die Fähigkeiten von LLMs erstaunlich:

    Texte verstehen und zusammenfassen. Geben Sie einem LLM einen zwanzigseitigen Vertrag, und es liefert Ihnen in Sekunden eine präzise Zusammenfassung der wichtigsten Punkte.

    Zwischen Sprachen übersetzen. Da das Modell Texte in Dutzenden Sprachen gelesen hat, hat es deren Muster verinnerlicht und kann flüssig zwischen ihnen wechseln.

    Komplexe Sachverhalte erklären. Ein LLM kann ein und dasselbe Thema für ein Fachpublikum, für Studierende oder für Zehnjährige erklären – weil es gelernt hat, wie Menschen auf verschiedenen Niveaus kommunizieren.

    Programmcode schreiben. Code ist letztlich auch eine Sprache mit klaren Regeln, und LLMs haben Millionen von Programmen in ihren Trainingsdaten gesehen.

    Kreativ formulieren. Ob Gedicht, Werbetext oder Kurzgeschichte – LLMs können stilistisch erstaunlich vielseitig sein.

    All diese Stärken haben eines gemeinsam: Es geht um Muster in der Sprache. Und genau darin sind LLMs Weltmeister.

    Wo die Maschine scheitert: Das Kreuzworträtsel-Problem

    Und damit kommen wir zum Kreuzworträtsel. Stellen Sie sich folgende Aufgabe vor:

    Gesucht: Europäische Hauptstadt, 4 Buchstaben, dritter Buchstabe ist ein „r”.

    Für einen Menschen ist das einfach. Wir denken an Hauptstädte, zählen die Buchstaben ab, prüfen den dritten – und kommen auf „Bern”.

    Für ein LLM ist genau diese Aufgabe ein Albtraum. Und der Grund liegt in dem, was wir vorhin über Tokens gelernt haben.

    Das Token-Problem

    Erinnern Sie sich: Ein LLM sieht keine einzelnen Buchstaben. Es sieht Tokens – Wortfragmente, die oft mehrere Buchstaben umfassen. Das Wort „Bern” ist für das Modell ein einzelner Token, ein unteilbares Stück. Es hat keinen direkten Zugang zu der Information, dass „Bern” aus den Buchstaben B-e-r-n besteht, dass es vier Buchstaben hat, oder dass der dritte davon ein „r” ist.

    Das ist, als würde man Sie bitten, den dritten Buchstaben eines Wortes zu nennen – aber Sie dürfen das Wort nur als versiegelten Umschlag sehen, ohne hineinzuschauen.

    Was das Modell stattdessen tut

    Wenn ein LLM mit einer Kreuzworträtsel-Frage konfrontiert wird, versucht es, das zu tun, was es immer tut: Es sucht nach Mustern. Es hat in seinen Trainingsdaten vielleicht Kreuzworträtsel-Lösungen gesehen und kann manchmal die richtige Antwort „erraten” – nicht weil es die Buchstaben wirklich zählt, sondern weil es das Muster „Europäische Hauptstadt + 4 Buchstaben” mit „Bern” assoziiert hat.

    Aber sobald die Aufgabe etwas kniffliger wird – etwa wenn eine ungewöhnliche Buchstabenkombination gefragt ist oder wenn es keine geläufige Assoziation gibt – scheitert das Modell kläglich. Es rät dann oft falsch und behauptet dabei mit großer Überzeugung, die Antwort sei korrekt.

    Was wir daraus lernen

    Dieses Beispiel zeigt eine fundamentale Einschränkung: LLMs verarbeiten Sprache nicht so, wie wir Menschen das tun. Sie haben kein inneres Modell von Buchstaben, Silben oder der physischen Struktur von Wörtern. Sie operieren auf einer anderen Ebene – der Ebene statistischer Muster zwischen Token-Sequenzen.

    Das bedeutet auch: Was für uns Menschen trivial einfach ist, kann für ein LLM unlösbar schwer sein – und umgekehrt. Eine dreißigseitige wissenschaftliche Arbeit zusammenzufassen ist für ein LLM ein Leichtes. Zu zählen, wie oft der Buchstabe „e” in einem Satz vorkommt, kann es dagegen überfordern.

    Was heißt das für den Alltag?

    LLMs sind mächtige Werkzeuge – aber eben Werkzeuge, keine denkenden Wesen. Sie erkennen und reproduzieren Muster in Sprache auf einem Niveau, das noch vor wenigen Jahren undenkbar schien. Aber sie verstehen die Welt nicht in dem Sinne, wie wir Menschen das tun.

    Wer das im Kopf behält, kann LLMs enorm gewinnbringend einsetzen: als Recherche-Hilfe, als Schreibassistenz, als Sparringpartner für Ideen, als Übersetzer, als Erklärer komplexer Sachverhalte. Man sollte ihre Ausgaben aber immer kritisch prüfen – besonders dort, wo es auf exakte Details ankommt, die sich nicht aus sprachlichen Mustern ableiten lassen.

    Die nächste Generation von KI-Systemen arbeitet bereits daran, einige dieser Schwächen zu überwinden – etwa durch die Fähigkeit, zwischendurch „nachzudenken” und Probleme schrittweise zu lösen, statt immer nur das nächste Wort vorherzusagen. Aber das Grundprinzip bleibt: Diese Systeme sind Meister der Mustererkennung. Und das ist gleichzeitig ihre größte Stärke und ihre fundamentalste Grenze.


    Dieser Artikel erklärt die grundlegende Funktionsweise sogenannter Large Language Models (LLMs) in vereinfachter Form. Die tatsächliche technische Umsetzung ist in vielen Details komplexer, als hier dargestellt.

  • 80 % Cybersecurity ist ITIL — Warum wir aufhören sollten, Security und IT zu trennen

    80 % Cybersecurity ist ITIL — Warum wir aufhören sollten, Security und IT zu trennen

    Von Christoph Gruber, CTO & CISO

    Eine unbequeme Beobachtung aus München

    Ich sitze auf der Munich Cyber Security Conference 2025, höre den Vorträgen zu, folge den Diskussionen — und mir fällt etwas auf, das mich seit Jahren beschäftigt: Die meisten Akteure in der Cybersecurity-Branche verhalten sich so, als wäre ihr Fachgebiet völlig unabhängig von der IT.

    Eigene Budgets. Eigene Abteilungen. Eigene Tools. Eigene Konferenzen. Eine eigene Sprache. Eine eigene Karriereleiter.

    Und ich frage mich: Wann genau haben wir beschlossen, dass Cybersecurity keine IT-Disziplin mehr ist?

    Die unbequeme Wahrheit: Ein CISO arbeitet in ITIL

    Wenn ich mir anschaue, was ein CISO im Tagesgeschäft tatsächlich verantwortet, dann komme ich zu einem Ergebnis, das auf Security-Konferenzen niemand gerne hört: Rund 80 Prozent der operativen Aufgaben eines CISO sind in ITIL bereits vollständig abgebildet.

    Das ist keine Provokation um der Provokation willen. Es ist eine nüchterne Analyse:

    Change Management ist vielleicht das deutlichste Beispiel. Unkontrollierte Änderungen an Systemen gehören zu den häufigsten Angriffsvektoren. Wer ein sauberes Change Management betreibt, hat einen erheblichen Teil seiner Security-Probleme bereits gelöst — ganz ohne ein einziges Security-Tool.

    Incident Management bildet die direkte Grundlage für Security Incident Response. Die Prozesse sind nahezu identisch: Erkennung, Klassifizierung, Eskalation, Behebung, Lessons Learned. Ob ein Server wegen eines Hardwaredefekts ausfällt oder wegen eines Ransomware-Angriffs — der Prozess ist derselbe.

    Configuration Management und eine gepflegte CMDB sind die Voraussetzung für jedes Schwachstellenmanagement. Ohne vollständiges Asset-Inventar kein Patching. Ohne Patching keine Security. So einfach ist das.

    Access Management in ITIL ist praktisch deckungsgleich mit Identity and Access Management in der Security-Welt. Dieselben Prinzipien, dieselben Prozesse, nur mit anderem Etikett.

    Service Continuity Management deckt Business Continuity und Disaster Recovery ab — Kernthemen jedes CISO.

    Supplier Management ist die Basis für Third Party Risk Management, das gerade durch NIS2 und DORA in Europa enorm an regulatorischer Bedeutung gewonnen hat.

    Die Liste lässt sich fortsetzen. Problem Management, Availability Management, Information Security Management — ITIL hatte das alles schon, bevor „Cybersecurity“ zum Milliardenmarkt wurde.

    Was bleibt dann noch?

    Die verbleibenden 20 Prozent — die Bereiche, die tatsächlich spezifische Security-Expertise erfordern — sind wichtig, keine Frage: Threat Intelligence, Penetration Testing, Red Teaming, forensische Analyse, das adversariale Denken in Bedrohungsszenarien.

    Aber selbst diese Disziplinen funktionieren nicht im luftleeren Raum.

    Und hier wird es wirklich unbequem: Was macht eine Security-Architektur ohne IT-Architektur? Sie produziert PowerPoints.

    Man kann die elegantesten Zero-Trust-Konzepte entwerfen. Aber wenn man nicht weiß, wie das Netzwerk segmentiert ist, welche Applikationen über welche Schnittstellen kommunizieren und wo die Daten tatsächlich liegen, bleibt das Ganze eine theoretische Übung. Security Architecture ist keine eigenständige Disziplin — sie ist eine Spezialisierung innerhalb der IT-Architektur. Oder sie ist wertlos.

    Dasselbe gilt für Penetration Testing ohne Kenntnis der Infrastruktur. Für Threat Intelligence ohne Verständnis der eigenen Angriffsfläche. Für Vulnerability Management ohne funktionierende CMDB.

    Warum die Trennung trotzdem existiert

    Wenn die Überlappung so offensichtlich ist, warum halten wir an der Trennung fest? Ich sehe drei Gründe:

    Erstens: Geld. Die Cybersecurity-Branche ist ein Wachstumsmarkt. Eigene Budgets, eigene Abteilungen und eigene Beratungsmandate lassen sich leichter rechtfertigen, wenn man Security als eigenständige Disziplin positioniert. Das ist nicht verwerflich — es ist Marktlogik. Aber es ist auch nicht im besten Interesse der Organisationen, die wir schützen sollen.

    Zweitens: Ego. Auf beiden Seiten. Der IT-Betrieb sieht Security oft als Störfaktor, der Prozesse verlangsamt. Security sieht den IT-Betrieb als inkompetent und nachlässig. Beide Seiten profitieren von der Trennung, weil sie die jeweils andere Seite für Versäumnisse verantwortlich machen können.

    Drittens: Regulatorik. NIS2, DORA und andere Regularien fordern explizit Security-Verantwortlichkeiten auf Leitungsebene. Das ist richtig und wichtig. Aber die Schlussfolgerung, dass diese Verantwortlichkeiten in einer von der IT isolierten Struktur besser aufgehoben sind, ist ein Trugschluss.

    Die Ironie

    Die größte Ironie, die ich in meiner Beratungspraxis erlebe: Organisationen, die ihre ITIL-Prozesse wirklich sauber leben, sind fast immer deutlich sicherer als solche, die Millionen in Security-Tools investieren, aber kein ordentliches Change Management haben.

    Ein Unternehmen mit einer aktuellen CMDB, sauberem Change Management, funktionierendem Incident Management und konsequentem Access Management hat seine Hausaufgaben gemacht. Die Security-Tools obendrauf sind dann das Sahnehäubchen — nicht das Fundament.

    Umgekehrt habe ich Unternehmen gesehen, die SIEM, SOAR, EDR, XDR und ein ganzes Alphabet an Security-Lösungen betreiben — aber nicht wissen, wie viele Server sie haben.

    Was folgt daraus?

    Ich plädiere nicht dafür, die Rolle des CISO abzuschaffen. Ich plädiere dafür, sie ehrlich zu definieren.

    Ein CISO, der seine Aufgabe ernst nimmt, muss die IT-Prozesse seiner Organisation nicht nur kennen, sondern mitgestalten. Er muss ITIL nicht als fremdes Framework betrachten, sondern als sein wichtigstes Werkzeug. Und er muss den Mut haben, in Security-Meetings zu sagen: „Das lösen wir nicht mit einem neuen Tool, sondern mit einem sauberen Change-Prozess.“

    Die eigentliche Frage ist nicht, ob wir Security und IT trennen sollten. Die Frage ist, ob wir es uns leisten können, so zu tun, als wären sie jemals getrennt gewesen.

    #MCSC #CISO #CIO #ITIL #ISMS

  • AI in Cybersecurity: Risks and Countermeasures

    AI in Cybersecurity: Risks and Countermeasures

    Table of Contents

    1. Overcoming Protective AI
    2. Confusing the Protection AI
    3. Model Poisoning
    4. When Protection Becomes the Attacker
    5. Deepfake Attacks & AI-Assisted Social Engineering
    6. Autonomous AI Attackers
    7. Model Theft & Model Espionage
    8. Supply Chain Poisoning Through AI
    9. Manipulation of Decision AI
    10. Shadow AI

    1. Overcoming Protective AI

    Scenario Description

    In this scenario, attackers focus on directly overcoming or bypassing AI-based security systems. Modern cybersecurity solutions increasingly rely on artificial intelligence for anomaly detection, malware identification, and attack recognition. However, attackers are increasingly developing techniques to circumvent these AI protection measures.

    Examples include:

    • Development of malware that adapts to known detection patterns and is thus classified as harmless by AI systems
    • Use of „Adversarial Machine Learning“ techniques that specifically generate inputs designed to mislead AI systems
    • Exploitation of „blind spots“ in trained models that cannot detect certain attack vectors

    Countermeasures

    • Continuous re-training of protection AI with current threat data
    • Implementation of multi-layered defense systems (Defense-in-Depth)
    • Adversarial training of protection models to increase resistance against deception attempts
    • Combination of rule-based and AI-based security systems
    • Development of meta-AI systems that monitor the behavior of primary protection AI

    Relevance for Cybersecurity

    The increasing dependence on AI-based security solutions creates a new battlefield in cyberspace. When attackers can overcome protective AI, potentially all underlying systems are at risk. Particularly critical is that successful attacks against AI systems are often difficult to detect, as they occur within the normal operating parameters of the AI. This leads to dangerous false security when companies blindly trust their AI security systems without understanding their vulnerabilities.

    2. Confusing the Protection AI

    Scenario Description

    This scenario involves techniques aimed at confusing or misleading AI-based security systems through deliberate injection of misleading data, without directly overcoming them. Unlike direct bypassing, this is about impairing the functionality and effectiveness of AI by degrading its recognition capabilities through interference signals or noise.

    Methods include:

    • Generation of targeted „noise“ in network traffic to overload anomaly detection systems
    • Provoking frequent false alarms to create an „alarm fatigue“ effect in security teams
    • Gradual injection of manipulated data that shifts the AI’s normal baseline understanding

    Countermeasures

    • Implementation of robust filters against data noise and unusual input patterns
    • Development of self-calibrating AI systems that detect baseline shifts
    • Use of independent validation systems that monitor main detection systems
    • Regular manual review of detection quality by security experts
    • Implementation of „canary tokens“ and other early warning systems

    Relevance for Cybersecurity

    Confusing protection AI represents a subtle but dangerous threat. Instead of conducting direct attacks, attackers can undermine trust in automated security systems through continuous manipulation of the AI environment. This is particularly problematic as modern Security Operations Centers (SOCs) operate under a constant stream of alerts and rely on reliable AI filtering. A confused AI can significantly deteriorate an organization’s security posture through both excessive false alarms and overlooking genuine threats.

    3. Model Poisoning

    Scenario Description

    Model poisoning describes attacks that target the training phase of AI security models. Manipulated data is introduced into training datasets to compromise the resulting model. Unlike attacks against already trained models, vulnerabilities are directly built into the basic structure of the protection model.

    Attack forms include:

    • Data Poisoning: Injection of manipulated training data
    • Backdoor attacks: Implementation of hidden triggers in the model that cause specific misreactions
    • Label Flipping: Targeted mislabeling of training data to shift classification boundaries

    Countermeasures

    • Strict validation and quality control of training data
    • Use of techniques for detecting anomalies in training data
    • Regular review of model behavior with trusted test data
    • Differential learning and other privacy-enhancing training methods
    • Distributed training with independent validation by multiple parties

    Relevance for Cybersecurity

    Model poisoning is particularly dangerous because it is difficult to detect and builds fundamental vulnerabilities into the security system. A poisoned model can appear normal for a long time and only fail under certain conditions – exactly when an attacker desires it. As more companies rely on pre-trained models or external datasets, the risk increases that such „poisoned“ components are integrated into their own security infrastructure. The long-term impacts can be devastating as trust in the entire AI-based security architecture is undermined.

    4. When Protection Becomes the Attacker

    Scenario Description

    This scenario describes situations where AI-based security systems themselves are compromised and turned against their operators or other systems. Instead of passive failure, the system becomes actively hostile and uses its privileged position and capabilities for attacks.

    Possible manifestations:

    • Takeover of control over AI security systems by attackers
    • Manipulation of autonomous security responses to conduct DoS attacks
    • Exploitation of privileged system access of security AI for lateral movement
    • Repurposing of detection and analysis capabilities for espionage purposes

    Countermeasures

    • Strict isolation and access controls for AI security systems
    • Implementation of „guardrails“ and limitation of autonomous action capabilities
    • Regular security audits of the AI systems themselves
    • Monitoring of security AI behavior by independent systems
    • Emergency shutdown mechanisms and recovery plans

    Relevance for Cybersecurity

    The reversal of protection measures into attack tools represents a particularly dangerous development. Security AI typically has comprehensive permissions, detailed infrastructure knowledge, and often the ability to initiate automated countermeasures. When such AI is compromised, it can misuse these legitimate capabilities for attacks. This challenges the fundamental paradigm of cybersecurity: when protection mechanisms themselves can become threats, a complex meta-security problem emerges. Companies must consider this new threat level and view security systems not only as protection measures but also as potential risk factors.

    5. Deepfake Attacks & AI-Assisted Social Engineering

    Scenario Description

    In this scenario, advanced AI technologies are used to conduct highly realistic and personalized social engineering attacks. Through the use of deepfakes, attackers can create deceptively real audio, video, and text content that can fool even trained employees.

    Attack forms include:

    • Creation of synthetic audio content for vishing attacks (Voice Phishing) that imitate the voices of supervisors or colleagues
    • Generation of deceptively real video content for trusted communication
    • Highly personalized phishing messages based on data collected from social media
    • Real-time manipulation of video and audio streams during video conferences

    Countermeasures

    • Implementation of multi-factor authentication with additional verification steps
    • Use of deepfake detection technologies for incoming communication
    • Employee training on AI-based social engineering techniques
    • Establishment of strict verification protocols for sensitive requests
    • Development and use of digital signatures for authenticated communication

    Relevance for Cybersecurity

    Deepfake-based attacks represent a dramatic evolution of traditional social engineering methods. While conventional phishing attacks were often recognizable through linguistic or contextual errors, AI-generated content enables extremely convincing deceptions. This fundamentally undermines the previously effective human detection of social engineering attempts. The consequences can be severe: from identity theft to data loss to financial damage through fake payment instructions. Particularly concerning is the increasing accessibility of these technologies to less specialized attackers through user-friendly AI tools, which could dramatically increase the frequency and spread of such attacks.

    6. Autonomous AI Attackers

    Scenario Description

    This scenario describes the emergence of partially or fully autonomous AI systems that can conduct cyber attacks without continuous human control. Unlike conventional automated attacks, these AI systems can independently plan, adapt, and respond to countermeasures.

    Characteristics of autonomous AI attackers:

    • Independent exploration and mapping of networks and systems
    • Dynamic adaptation of attack strategy based on encountered security measures
    • Automatic exploitation of discovered vulnerabilities
    • Continuous learning from successful and failed attack attempts
    • Coordinated actions across different systems and networks

    Countermeasures

    • Development of AI-based defense systems with comparable adaptability
    • Implementation of honeypots and deception technologies to mislead autonomous attackers
    • Regular „red team“ exercises with AI-assisted attack tools
    • Network segmentation and zero-trust architectures to limit freedom of movement
    • Real-time monitoring focused on unusual behavior patterns and coordinated activities

    Relevance for Cybersecurity

    Autonomous AI attackers represent a fundamental shift in the power balance of cybersecurity. Traditionally, defense was based on the assumption that human defenders would face human attackers – with similar cognitive limitations, working hours, and resources. However, autonomous AI attackers operate continuously, can analyze numerous targets in parallel, and remain unaffected by factors like fatigue or emotional decisions. This leads to an asymmetric threat situation, as even well-equipped security teams may struggle to keep pace with the speed and scope of such attacks. The potential proliferation of such technologies could lead to a „democratization“ of advanced cyber capabilities, enabling even less experienced actors to conduct complex attacks.

    7. Model Theft & Model Espionage

    Scenario Description

    This scenario encompasses attacks aimed at stealing, extracting, or reconstructing proprietary AI models. As AI models increasingly represent valuable intellectual property assets and significant investments, they themselves become targets of attacks.

    Methods for model theft and espionage:

    • Model Extraction Attacks: Systematic querying of an AI service to reconstruct a similar model
    • Insider theft of model parameters or training data
    • Reverse engineering of AI components in security products
    • Supply chain attacks aimed at gaining access to models during development
    • Inference attacks to extract model behavior or training methodology

    Countermeasures

    • Implementation of query limiting and rate control for AI services
    • Use of watermarks in AI models for traceability
    • Encryption and secure storage of model parameters and training weights
    • Access control and monitoring for model development and deployment
    • Contractual protection and careful licensing of AI technologies

    Relevance for Cybersecurity

    Model theft and espionage represent a growing threat as AI models increasingly become core to business models and security systems. Compromising proprietary AI models can have several serious consequences:

    1. Economic damage through loss of competitive advantages and R&D investments
    2. Increased security risk when attackers gain detailed knowledge about detection models
    3. Potential for targeted attacks based on acquired knowledge about model structure and weaknesses
    4. Risk of model manipulation by attackers if they gain access to a model

    With the rising economic value of AI technologies, companies must view them not only as tools but also as assets worthy of protection and implement appropriate security measures.

    8. Supply Chain Poisoning Through AI

    Scenario Description

    This scenario describes attacks on the development and supply chain of AI components and systems. Similar to traditional supply chain attacks, these aim to introduce vulnerabilities or backdoors during development or distribution.

    Attack vectors include:

    • Compromising public model repositories and pre-trained models
    • Infiltrating malicious components into AI development libraries
    • Manipulating training data through their supply chain (Data Supply Chain)
    • Introducing hidden functions into commercial AI products
    • Compromising data processing pipelines for continuous training

    Countermeasures

    • Thorough examination and validation of external AI components before integration
    • Implementation of Software Bill of Materials (SBOM) for AI systems
    • Building trusted supply chains for training data and models
    • Regular security audits and penetration testing for AI development environments
    • Use of cryptographic signatures and integrity checks for AI components

    Relevance for Cybersecurity

    Supply chain attacks through AI represent a particularly serious threat as they target AI security systems at their source. Modern AI development is heavily dependent on external components, public datasets, and pre-trained models, which provides numerous attack surfaces. Particularly problematic is that such compromises are very difficult to discover and are often only recognized after extended periods when they are already integrated into production systems. As AI systems increasingly take over critical security functions, a compromised AI supply chain can have far-reaching consequences for the cybersecurity of entire organizations. Companies must therefore extend their security measures to the entire AI supply chain and not focus only on the deployment of finished systems.

    9. Manipulation of Decision AI

    Scenario Description

    This scenario deals with the targeted manipulation of AI systems used for business-critical or security-relevant decisions. Unlike classic attacks on IT infrastructure, this involves subtly influencing AI decision-making without directly compromising the systems.

    Manipulation techniques include:

    • Subtle influence of input data to provoke biased decisions
    • Exploitation of known bias in models for predictive security analyses
    • Targeted manipulation of external data sources used for continuous learning
    • „Perception Hacking“ – manipulation of the physical world to deceive sensors and their AI-based interpretation
    • Subtle Manipulation Attacks (SMA) – minimal changes to data that are invisible to humans but alter AI decisions

    Countermeasures

    • Implementation of robust procedures for detecting input manipulations
    • Regular review for bias and unexpected decision patterns
    • Diversification of data sources and decision models
    • Development of more explainable AI models (Explainable AI) for better traceability
    • Human oversight of critical AI decisions with defined escalation paths

    Relevance for Cybersecurity

    Manipulation of decision AI represents a new generation of cyber attacks that don’t primarily aim at data theft or system destruction, but at subtle influence of decision processes. This threat is particularly relevant as companies and security organizations increasingly use AI systems for critical decisions – from threat detection to allocation of security resources. Successful manipulation can lead to systematic wrong decisions, such as misclassification of threats or inefficient allocation of security measures. Since such manipulations often occur within the normal operating parameters of AI, they can remain undetected for long periods and cause lasting damage. The cybersecurity industry must therefore develop methods to protect not only the integrity of systems but also the integrity of AI-based decision processes.

    10. Shadow AI

    Scenario Description

    Shadow AI describes the uncontrolled and unauthorized use of AI technologies within an organization, similar to the concept of „Shadow IT.“ Employees or departments implement AI solutions outside official IT governance structures, often with the goal of achieving productivity gains or introducing innovative solutions more quickly.

    Manifestations of Shadow AI:

    • Use of public AI services for business-relevant tasks without security review
    • Development and deployment of unofficial AI models at department level
    • Uploading sensitive company data to external AI platforms for analysis
    • Integration of unreviewed AI components into existing applications
    • Use of personal AI assistants for business tasks

    Countermeasures

    • Development of enterprise-wide AI governance strategy with clear guidelines
    • Provision of reviewed and secure internal AI services as alternatives to external offerings
    • Implementation of monitoring systems to detect unauthorized AI usage
    • Employee training on risks of unsanctioned AI usage
    • Establishment of efficient review and approval processes for new AI applications

    Relevance for Cybersecurity

    Shadow AI represents a significant internal threat to cybersecurity that is often overlooked. Uncontrolled use of AI technologies can lead to several security risks:

    1. Data protection violations through transmission of sensitive data to external services
    2. Increased attack surface through unreviewed and unmonitored AI services
    3. Circumvention of established security controls and policies
    4. Potential introduction of manipulated or insecure AI components
    5. Lack of transparency and control possibilities for security teams

    With the increasing availability of user-friendly AI tools and services, Shadow AI is becoming a growing problem for organizations. The cybersecurity industry must develop an approach that promotes the innovative power of AI technologies while ensuring appropriate security controls.

  • Next Generation Security Attacks

    What we see right now

    Hacking

    Weaknesses in systems are used take over system, intrude the infrastrcture. This is done mostly without human interaction.
    Prevention is done technically by removeing vulnerabilities.
    Detection is done by vulnerability scanning and pentesting

    Phishing

    Weakness in human behavior is used to intrude systems.
    Success needs the actice contribution of humans.
    Prevention is done by increasing the awareness and enabling a hollistic and fast detection and response and strengthening the authentication and authorization procedure.

    Orchestrated Multi Modal Attack

    A combination of various attacks simultaniously, orchestrated by a team of skilled people following a strategy.
    This form of attack is very rare and limitted to very exposed targets, often driven by state actors or other well-organised groups.
    The effort is enormous and expensive and therefore only used for attacks with high value. (not only money).

    What will come

    Already visible

    Many attacks are performed automatically or semi-automated, just a little interaction on attackers side is needed.
    They just collect and sort the victims, use AI as tool to cathegorize the victims and set the ransom or other means of monetarising them.

    Near Future

    AI orchestrated multi-modal attacks will be seen soon. AI will use a set of attacks to get control over infrstructure and user accounts, will create distortion in the detection- and defense-systems on the victims side, will play hide-and-seek with the defense team and adopt the attacks to the reactions.
    In real time
    24/7
    As long as it takes
    Be prepared

  • How to destroy your Cyber Security

    You found it, you own it

    This management principle makes the finder of an issue the owner and makes her or him responsible for the fixing.
    As Cyber Security’s base action is to find weaknesses and 90%+ of these are to be fixed by standard IT Management processes, this principle works as a tar-pit to waste valuable and expensive workforce of Cyber Security experts for others tasks.

    Bureaucracy

    Tight your Security staff into processes that are as tight and inflexible as possible. Especially reporting-lines are here valuable contributor that the Security personnel is not allowed to talk directly to affected organisational units and have to follow the reporting lines to report.
    See other functions in the company as controller and not as supporter and burden the Security staff with reporting and planning tasks as much as possible.

    Budgetting

    Plan the constant yearly budget in money and personnel as tight as possible to have the Security Manager in need of justification any need at least yearly.
    Give money spontaneously with vague goals like „make faster“ and blame the Manager for not being able to spend it at year’s end. This accusation might also be used for restricting the next year’s budget by „You were not able to spend the money last year, now your are requesting more?“

    Project Management

    Burden the Security Team with as much planning and reporting tasks as possible, especially tasks that span a lot of teams within the company.

    Responsibility

    Make the Security team responsible for the results of others. The implementation of measures is of course left with these „other“ and prioritised by them.
    Emphasise a culture where Security is seen as disruption of important business functions by „busybodies“

    Add internal confusion

    Found additional units with „Security“ in the name and vague purpose to have the people’s time and energy consumed by turf wars.